
Salt & Salt++,我认为的正确的自回归视频生成是什么?
Published:
大家好,介绍一下最近做的自回归音视频生成的工作
Salt++: Context-Aligned Post-Training for Few-Step Streaming Multimodal Generation
- arXiv.org · Salt++: Context-Aligned Post-Training for Few-Step Streaming Multimodal Generation
- Project Page: Salt++: Context-Aligned Post-Training for Few-Step Streaming Multimodal Generation
- Github: Saltpp
之前在wan / self forcing系列模型上做的少步蒸馏工作Salt被ECCV 2026接收后,我们想要进一步向上游拓展,思考怎样才是一个高效的从预训练视频生成模型出发,训出一个自回归的视频模型/音视频生成模型,于是基于LTX-2,我们有了这篇Salt++。在这篇工作中,我们主要关心一个问题:当我们想把视频生成改成自回归生成,一个完整的后训练流程应该是什么样的?
这篇先借论文里的 Fig.2、3、7,把 Salt++ 的方法和实验结论串起来,再聊聊做这些实验时的感受,以及一些还未验证的想法。
从 Salt 到 Salt++:我们越来越重视 context 在视觉生成中的作用
Salt [ECCV 2026] 研究的是视频生成少步蒸馏。一方面,我们通过 Self-Consistent DMD,约束连续去噪更新的组合,使少步采样不只关注单次预测,也关注这些更新串起来之后的行为;另一方面,在自回归场景中,我们把 KV cache 看作质量会变化的条件,研究 cache-aware training。[1] 因此,在做Salt的时候就对context的问题有了一定意识:先前生成的内容会进入KV Cache,而KV Cache又会影响后面的生成。
到了 Salt++,我们将研究推进到因果的联合音视频生成,并进一步追问:一个完整的自回归视频生成后训练应该怎么做?为了回答这个问题,我们在这篇论文中,将自回归视频生成解耦成两个维度上的问题:一个维度是causal attention,另一个维度是step distillation
回顾self forcing, causal forcing++, causal-rcm等系列论文,我们能发现,self forcing的causal ode initialization,好像又在训causal attention,又在训一点4步生成,这一阶段模型的rollout结果还是糊糊的;随后借助4步的self rollout DMD继续,接着refine causal attention,以及进行step distillation(或更准确地说进行分布匹配)。到了causal forcing和causal rcm,则是通过teacher forcing → causal consistency distillation → self-rollout DMD来提升这两个维度能力的上限。但这件事给我的感觉是,work,但好像还是很“耦合”。似乎自回归生成下的少步蒸馏,还是需要通过causal CD → DMD这样稍显“间接”的形式来处理。
为此,我们分别在causal attention的维度,和step distillation的维度上,提出我们文中的方法,探究这两个维度上各自应该需要怎样的监督。
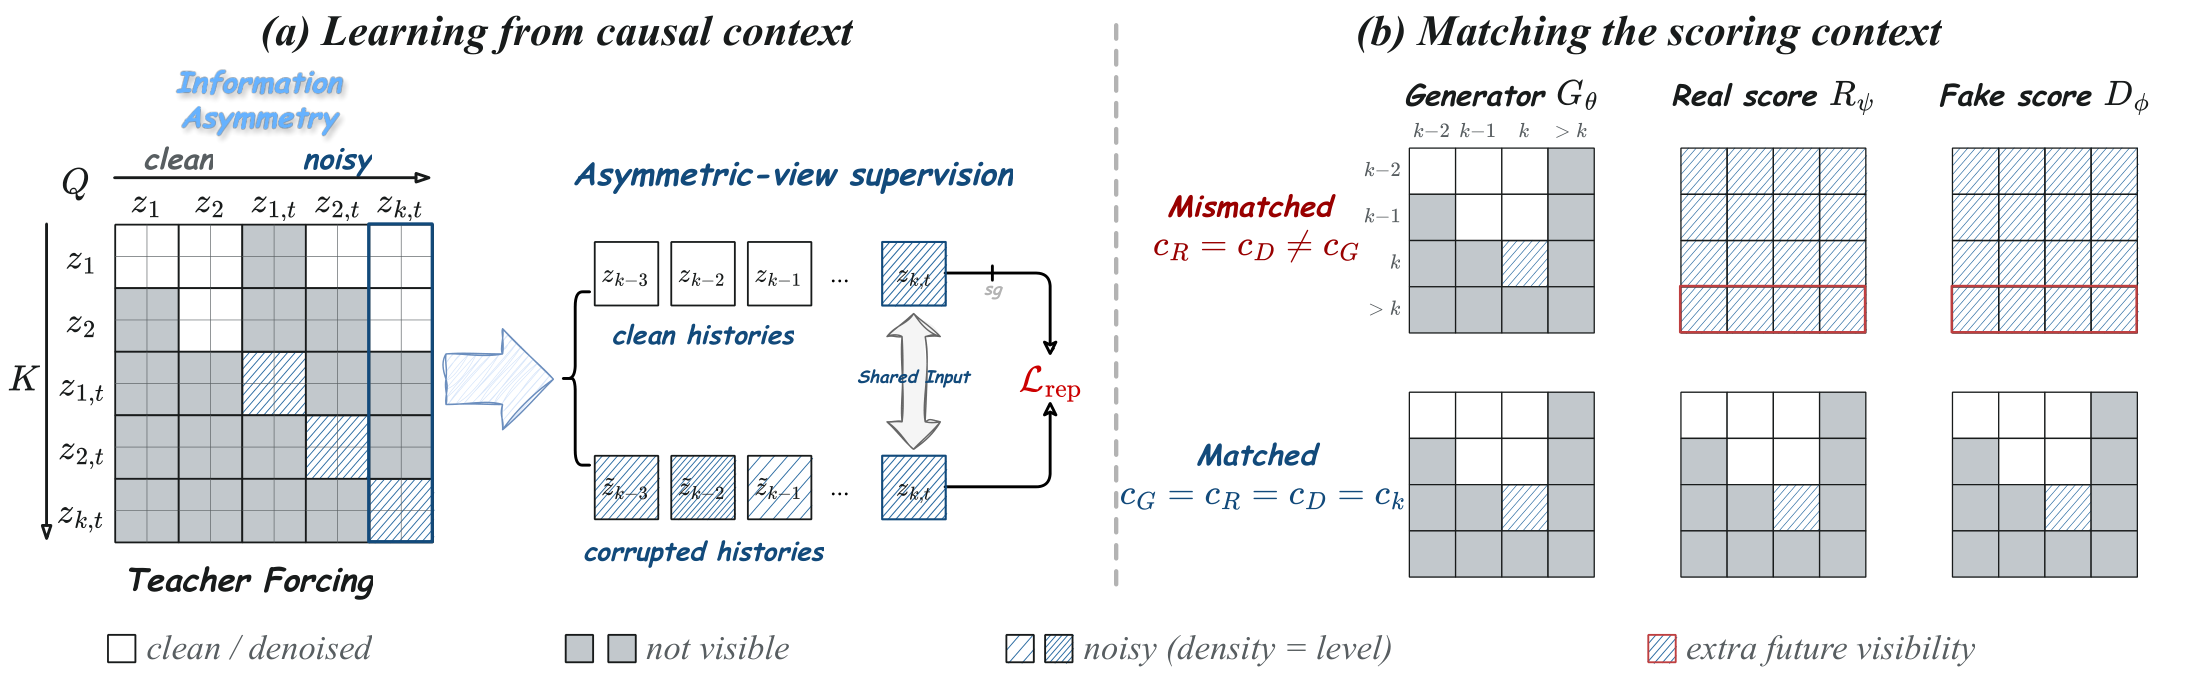
论文Fig.2:context 既是非对称信息来源,也提供了一个自监督条件
自回归音视频生成需要从过去提取对当前 chunk 有预测价值的信息:人物与场景的状态、动作的延续,以及声音和画面的关联。
Teacher forcing 提供了干净的历史和带噪的当前块,但常规 flow matching 对这些 contextual representations 的监督,仍主要通过监督velocity prediction来间接完成。我们的第一个问题是:能不能利用这种天然的信息不对称,构造更直接的自监督表征学习信号,如果可以,能达到什么样的效果?
Salt++ 的 Causal Self-Flow(CSF)让学生读取 noise-mixed history,让 EMA 老师读取对应的 clean history,同时保持双方的 noisy target 完全相同。我们对齐学生浅层投影后的表征与老师较深层的表征,并保留原本的 flow-matching 目标。这里,我们两个分支的输入差异只放在历史context中。模型要学习的是:如何从不完美的历史中,学习提取对当前块生成有益的那部分信息。实验上,CSF 改善了因果教师的音视频与音频文本对齐。
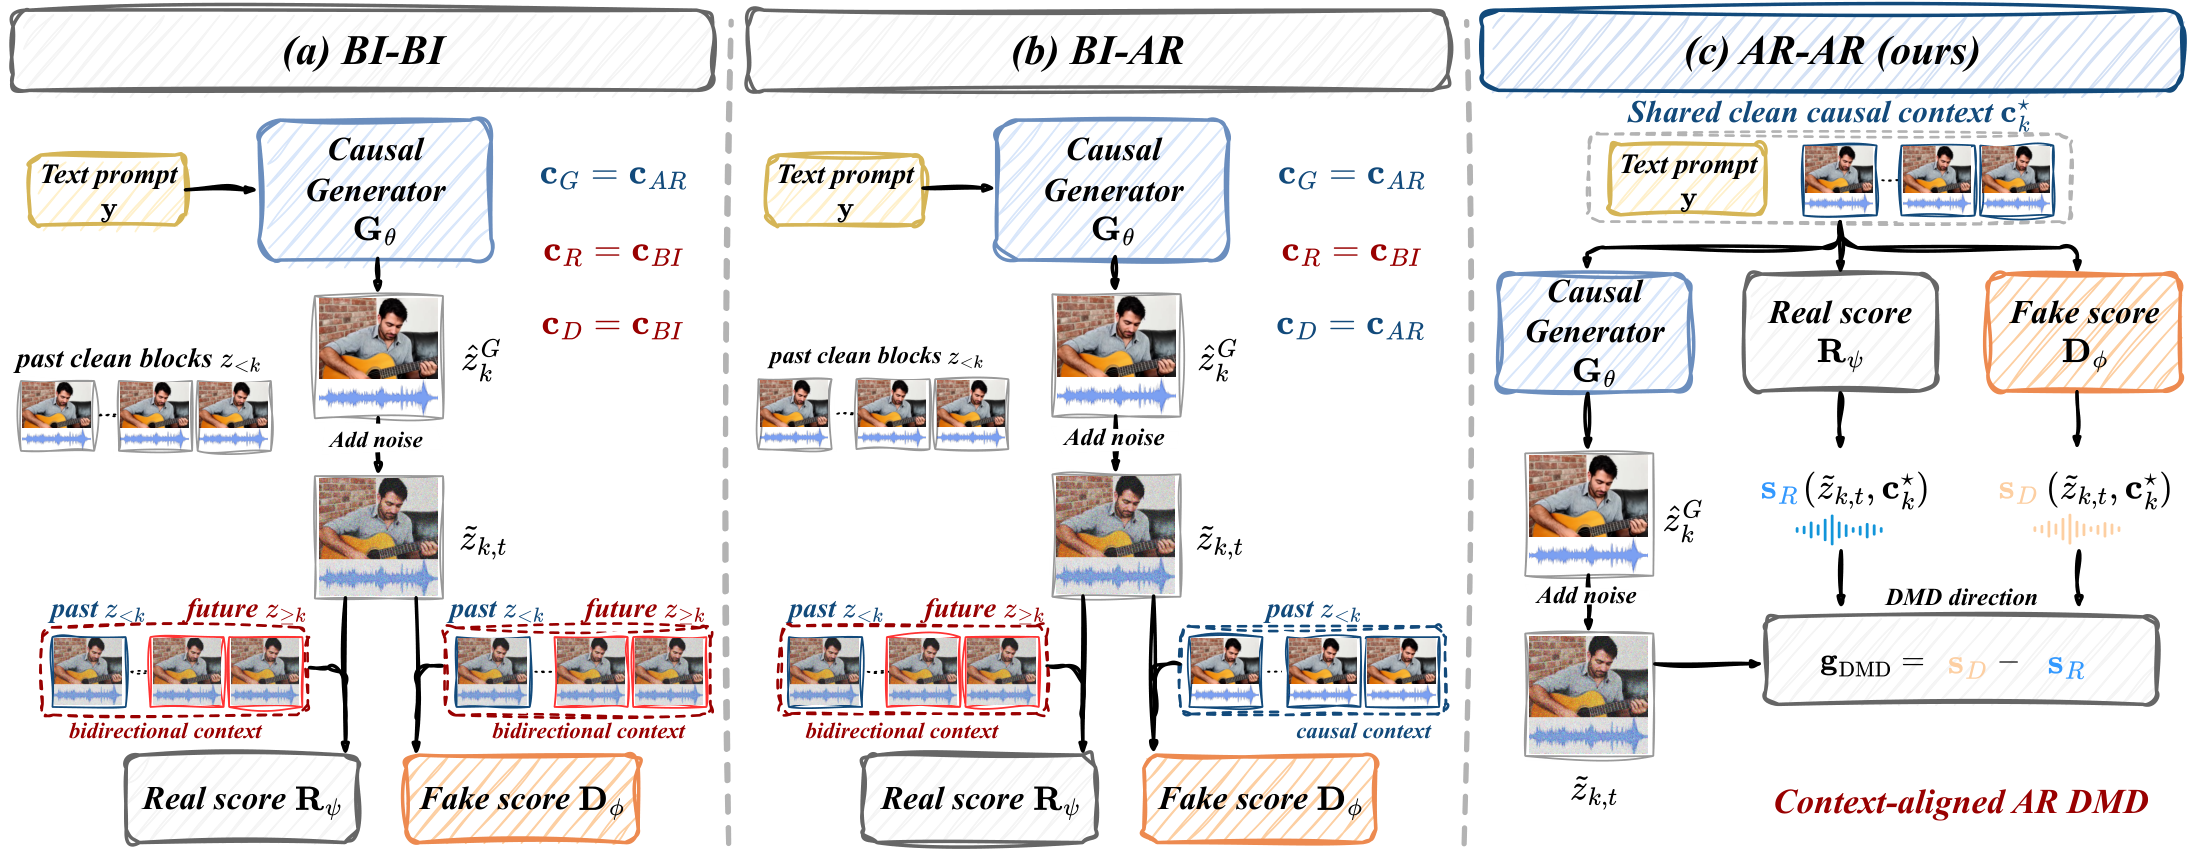
论文Fig.3:让DMD中三个模型的context对齐,则能进行一个很“正确”的少步蒸馏
DMD 里有三个关键角色:generator 负责进行少步生成;fake score model学习当前generator产生的样本分布;real score model则提供一个“好”的参考分布,real score和fake score的差值来描述两个分布之间KL散度的梯度方向。
训练DMD给我的经验和感受是,fake score model对generator样本分布的拟合能力至关重要,它也直接影响分布匹配的更新方向。我们之前在图像上的工作 SenseFlow 也探究过这个问题;到了自回归视频生成上,从这个角度看,先前的工作沿用 bidirectional score model 的 setting,fake score model在上下文/context的可见性、与generator生成时所看到的context来源上都存在显著差异:自回归生成时,generator 基于干净、固定的历史生成当前 chunk。因此,fake score 应该拟合的,也是这份历史条件下的当前块分布。但把生成的多个 chunk 拼起来、整段加噪,再交给双向 fake model 后,历史变成了带噪历史,当前块也能看到未来的信息。此时,fake model 拟合的条件分布已经不同。
从这个角度看,fake score model其实是在次优地拟合generator的样本分布。这也是我们认为先前的工作为什么需要先进行ode init / consistency distillation来先对generator进行一次较长阶段的训练,令其能够有一定的少步生成能力,让rollout出来的样本没有那么“差”了之后再去做DMD训练的原因。
换句话说,问题不只是 fake score 拟合得够不够好,还在于它是否拟合了正确的条件分布。对于 block-conditional DMD,我们需要保留生成时的历史chunk/context,只对生成的当前chunk重新加噪,让 fake score 在相同context下进行score matching训练。(详见论文Fig 3)
对于real score model,我们的实验结论也相同,在real score提供的也是逐chunk相同context下的参考分布时,自回归语境下的DMD能够取得最好的效果,详见论文Fig 7的结果,我们详细对比了consistency distillation以及DMD对应的Bidirectional / AR model不同配置下的生成效果。在real score / fake score同时使用bidirectional model (不经过consistency distillation阶段)时,蒸馏出来的generator会产生较为明显的逐chunk累计误差,这也呼应我们先前的分析。当二者同为和generator结构相同的AR model,并与generator共享相同context时,我们能够得到最好的少步生成效果。
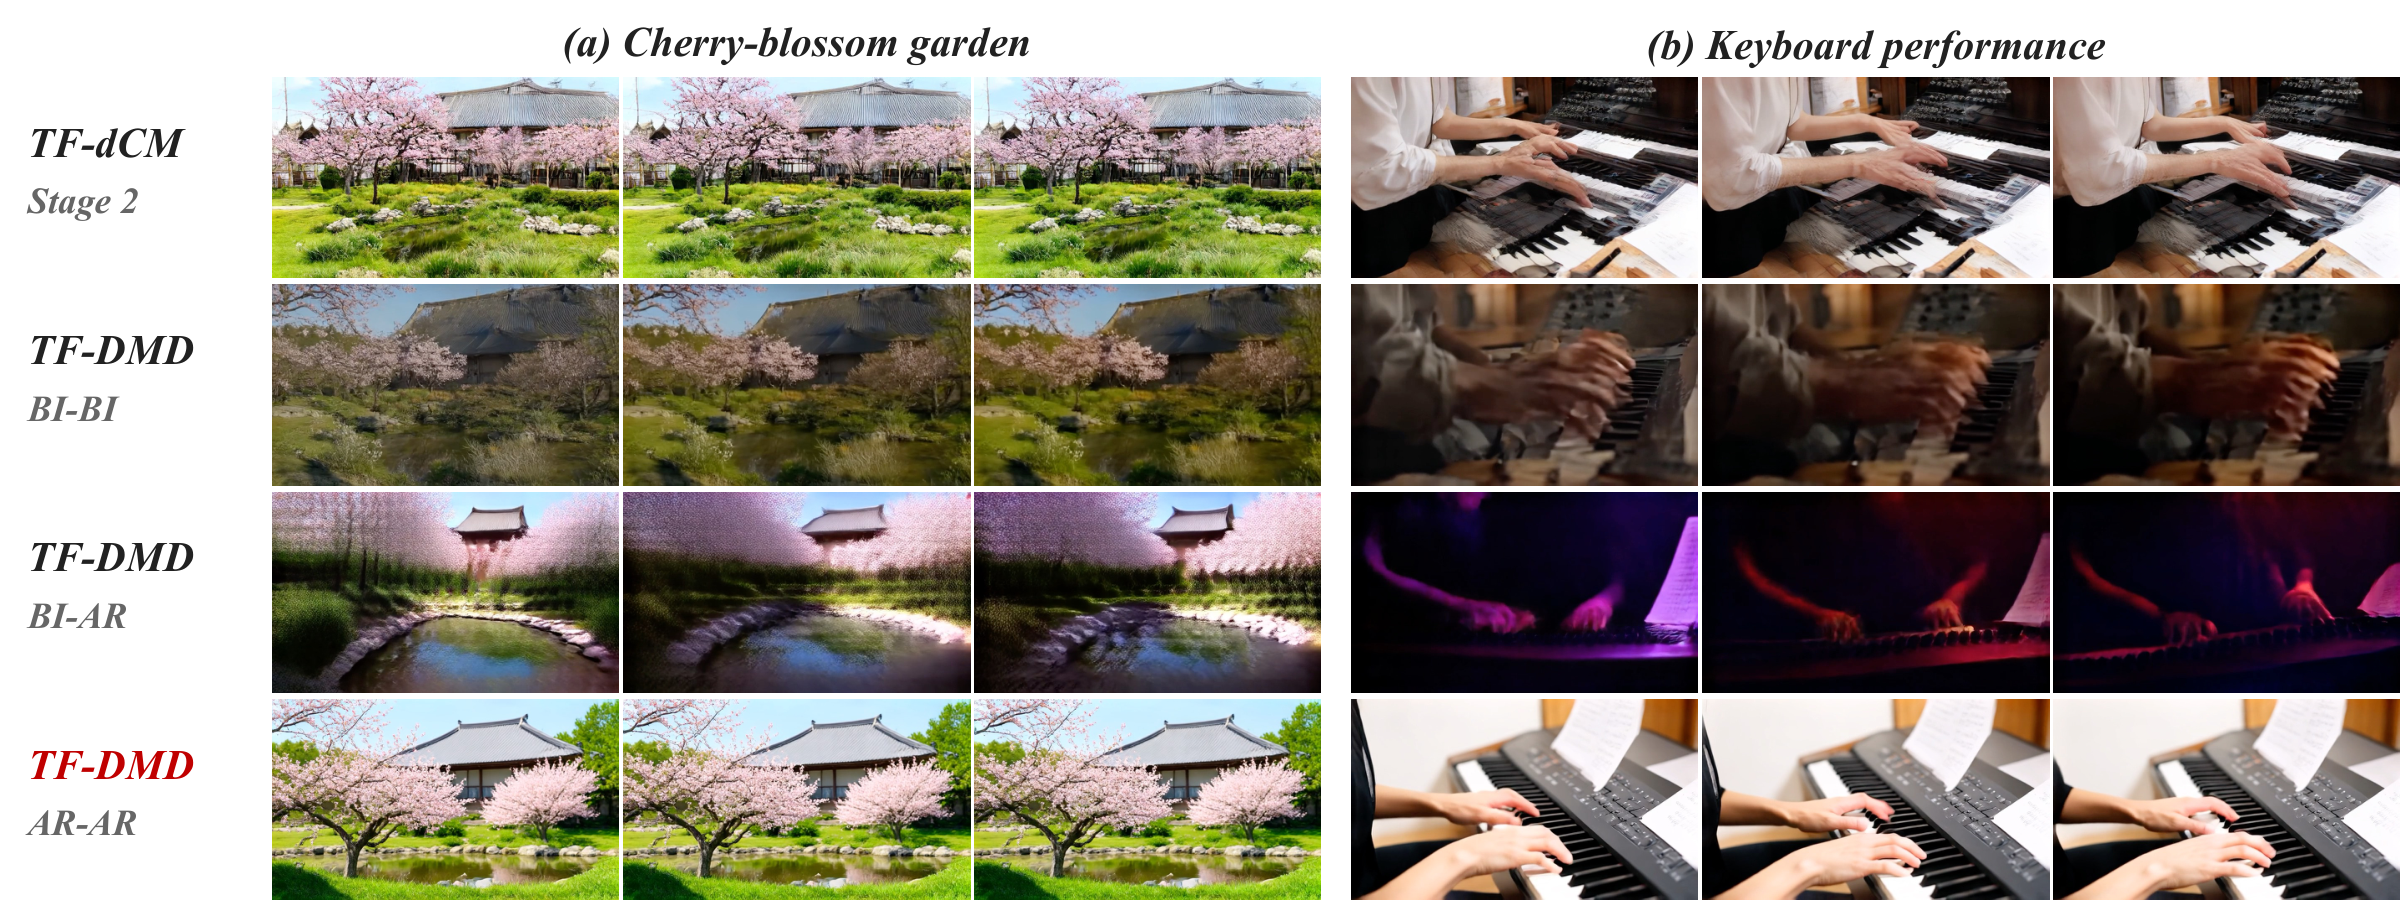
在提供了CSF阶段以及Context Aligned AR DMD阶段的训练后,我们就能够高效地得到一个few-step streaming generator,我们的实验结果表明,在JavisBench、VBench等主流Benchmark以及指标上,我们的方法能够显著优于基于ODE init或Consistency Distillation的pipeline,具体的实验结果对比可参考论文的实验章节。我们也会尽快将每个stage的ckpt以及训练/推理代码整理并开源出来。
前面是论文的方法和结果。下面是一些我的个人感受与猜想。
首先是,clean context 可能让更少步生成(如单步生成)变得可行:
在常见的双向整段去噪设置里,视频的各部分一起从噪声中形成。而生成一个自回归 chunk 时,前面的内容已经生成完了,会作为固定的 clean video context 被读取。人物是谁、场景大致是什么、物体在哪里、动作刚刚进行到哪里,已经有了一部分答案。所以,我觉得 AR 场景里的 context 提供的信息可能相对“更强”。这件事情让我觉得,可能可以对更少步 甚至单步生成更乐观。
之前在图像生成模型上训练单步,感受是训练非常tricky,以及一直存在细节不够、结构不对的问题,但相对而言,图像生成天然只靠用户提供的text prompt,而自回归视频则有更多的可用clean context。
其次,Context 更重要之后,要考虑“存什么”和“怎么写进去”:
存什么:紧凑,但不能丢掉预测需要的信息
人物身份可能要保持很久,近期动作需要细粒度状态,切镜时旧场景的一些信息应该淡出,但角色和声音身份又可能需要留下blabla。最近也有一些优秀的工作在探索这方面的context/memory design,如UnityShots[3] 区分长短期视频记忆,在镜头边界结合视听信号进行门控,并提供说话人身份参考等等方面来做multi-shot video generation;AnyFlow 的Causal版本沿用 FAR 的上下文压缩,通过不同的 patchify 粒度组织历史[4][5];WorldPlay2 [6]把历史压缩为紧凑记忆,用于学生生成和局部 clip 的评分,减少处理长 rollout 的开销等等。
怎么写:模型如何高效地将context写入KV Cache或者作为condition
这也是之前看到觉得很巧妙的地方,比如Self Gradient Forcing [7],已有的工作在生成完当前 chunk 后,把已去噪 latent 在 clean context timestep 下再次送入模型,得到 KV cache。按照这里的时间约定,这个时间步为 t=0。但t=0这个点,在pretrain、 post train阶段其实不一定有被高效地训练过,比如我们训练时往往会开比较大的timestep shift,SGF捕捉到了这一点,让来自DMD的gradient优化KV Cache的写入,矫正这个次优的”t=0”点,也是挺好玩的一件事。
最近的一个工作 context scaling[9] 也从文本条件的角度提供了一个有意思的观察:视觉生成的收益并不简单来自更长的 prompt,而与条件中包含多少明确、与图像对应的信息更相关。作者通过结构化表达对象、属性和空间布局等信息,观察到收敛后的 diffusion loss 随有效条件信息增加而下降。虽然它研究的是文生图,而不是视频历史或 KV cache,但这让我们更在意一个问题:我们应该关注的,不只是给生成模型多少 context,还包括 context 里有什么,以及模型能否真正用上这些信息。
再往前想:context 是否是 LLM / Agent 与视频生成之间的接口?
最近读了 Fuyun Wang 的《LLM 都会画画了,还需要训练视觉生成模型吗?》,很认同其中一个观点:LLM 的理解和规划能力变强,可以让视觉生成模型更有用。值得探索的是怎样把这些能力接起来,让模型能够根据生成结果继续判断、调整。
前段时间做了一通的流式视频生成之后,也感觉这个东西maybe有点像llm,本质上都是在做:
multimodal context → multimodal prediction
或许可以放在同一个框架下理解,只是多模态生成这里使用的是DiT来做prediction。LLM 读取上下文,预测后续 token;多模态生成则由 DiT 读取文本、历史音视频和其他context,生成后续的视听 chunk。于是,一个很自然的问题就是:上游模型能否参与构造每一步预测需要的 context?
比如,一个人物正在走向门口。人物的外观、房间布局、当前姿态和运动趋势,可以从视觉历史中获得;接下来是停下、推门,还是转身回应另一个人,则可以由上游根据用户意图和情节进展来安排。生成模型把这些信息结合起来,完成下一块具体的动作、画面和声音。
瞎想瞎写,总之觉得agentic generation这么看很有前景hhh,以及context 或许正是一个能让我们把这些问题放到一起研究的接口,尤其是在有了context scaling以及一些agentic video generation工作已经在探索的当下。
基于这些想法,少步生成是不是比diffusion基模型更接近“llm即AGI”这条主线?(暴论)
以上想法欢迎大家交流指正~
References
- Salt: Self-Consistent Distribution Matching with Cache-Aware Training for Fast Video Generation
- Salt++: Context-Aligned Post-Training for Few-Step Streaming Multimodal Generation。配图保留论文原编号;Fig.7 为少步初始化对照,完整流程指标见 Table 1。
- UnityShots: Memory-Driven Multi-Shot Audio-Video Generation with Boundary-Aware Gating
- AnyFlow: Any-Step Video Diffusion Model with On-Policy Flow Map Distillation。FAR 压缩的采用说明见 §4.3。
- Long-Context Autoregressive Video Modeling with Next-Frame Prediction(FAR)
- WorldPlay2: Extending Real-Time Interactive World Models in Control and Horizon
- Self Gradient Forcing: Native Long Video Extrapolation
- Fu-Yun Wang:LLM 都会画画了,还需要训练视觉生成模型吗?
- Scaling Properties of Text Conditioning in Visual Generation